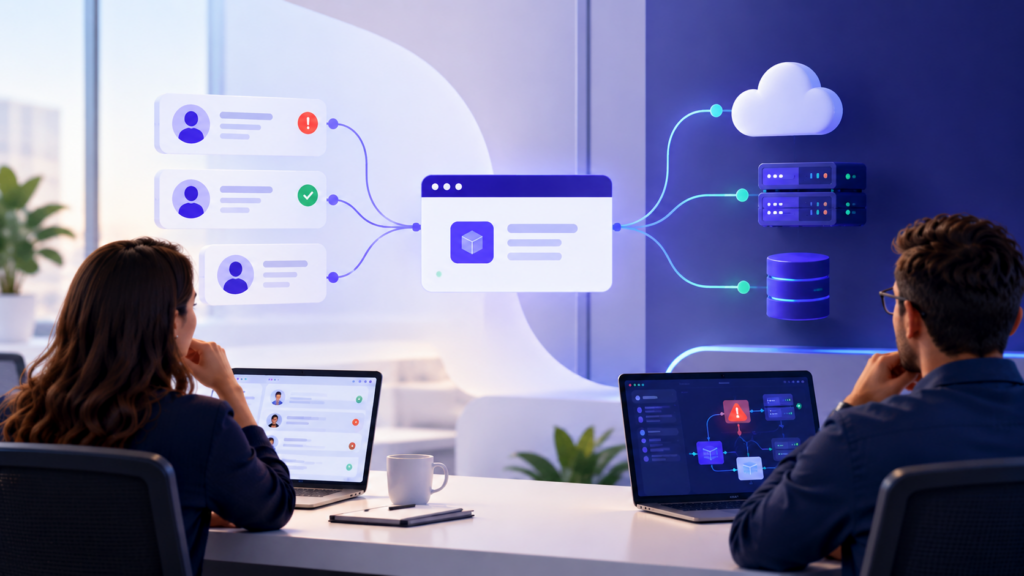
Per molto tempo IT Service Management e IT Operations hanno lavorato come due mondi paralleli. Il service desk si occupa delle richieste degli utenti e dei ticket, mentre i team operativi seguono l’infrastruttura e la disponibilità dei sistemi. Pur lavorando sugli stessi servizi, spesso utilizzano strumenti e priorità differenti.
Questa separazione si fa sentire soprattutto durante un disservizio. Un sistema rallenta, il monitoraggio genera un alert e poco dopo arrivano i primi ticket degli utenti. Lo stesso problema viene osservato da due punti di vista diversi, e ciascun team ha a disposizione solo una parte delle informazioni. Il tempo necessario per metterle insieme si aggiunge a quello della risoluzione.
Da questa esigenza nasce il concetto di ServiceOps, un approccio che porta la gestione dei servizi e la gestione delle operazioni IT all’interno dello stesso flusso di lavoro. L’obiettivo è fare in modo che chi deve intervenire abbia subito il contesto necessario, qualunque sia il punto da cui il problema è emerso.
Potrebbe interessarti anche:
IT Operations Management: Pratiche essenziali per una migliore erogazione del servizio
Il ServiceOps parte dai processi che esistono già
Adottare un approccio ServiceOps raramente richiede di riorganizzare l’IT o di creare nuove figure professionali.
Il punto di partenza è osservare cosa succede tra il momento in cui un problema viene rilevato e quello in cui viene risolto. In molte organizzazioni questo intervallo è occupato da passaggi manuali, con informazioni copiate da uno strumento all’altro e team in attesa di aggiornamenti.
Ridurre questi passaggi significa far lavorare ITSM e ITOM sullo stesso contesto, lasciando a ciascuno le proprie responsabilità.
I silos si notano soprattutto durante gli incidenti
Quando service desk e team operativi usano strumenti separati, ogni incidente richiede un lavoro di ricostruzione.
Il service desk riceve le segnalazioni degli utenti ma vede poco di ciò che accade nell’infrastruttura. I team tecnici, al contrario, ricevono gli alert senza sapere quanti utenti siano coinvolti.
Mettere insieme queste due prospettive richiede tempo, e quel tempo pesa direttamente sul MTTR. Una parte della gestione viene spesa per capire di che problema si tratta, prima ancora di iniziare a risolverlo.
Un alert acquista valore quando è collegato al servizio
Un picco di utilizzo della CPU può essere irrilevante in un momento e critico in un altro. Dipende da quali servizi si appoggiano a quel sistema in quel preciso momento.
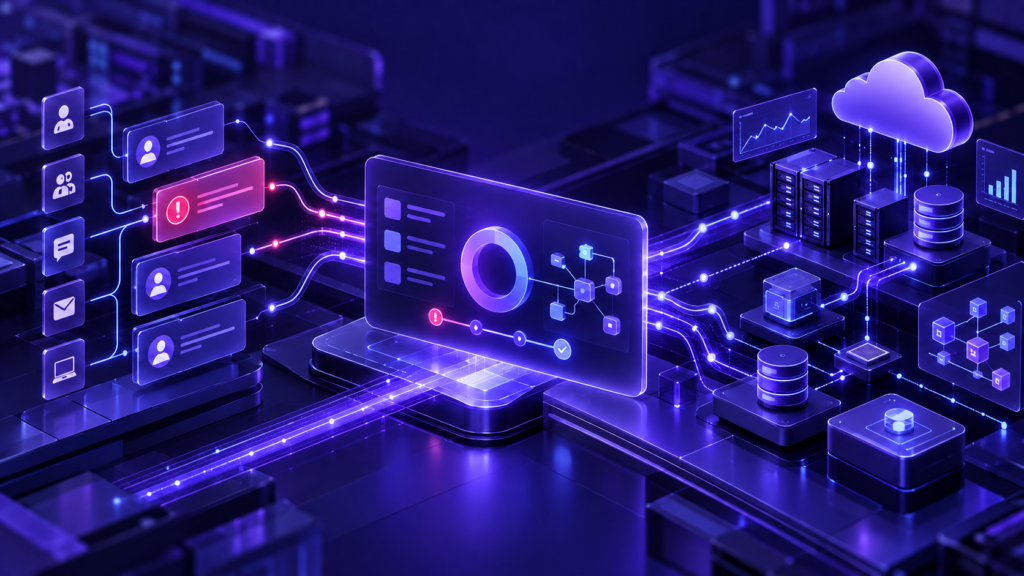
Per questo uno degli aspetti centrali del ServiceOps è la capacità di collegare gli eventi tecnici all’impatto sul servizio. Quando gli eventi del monitoraggio entrano nei processi di Service Management, possono essere correlati tra loro e diventare incidenti solo quando c’è un effetto reale sugli utenti.
Il team riceve così meno segnalazioni, ciascuna accompagnata da più contesto.
Il CMDB mette in relazione infrastruttura e servizi
Per capire quale servizio sia colpito da un evento tecnico bisogna sapere come i diversi componenti sono collegati tra loro.
Questa informazione si trova nel CMDB. Le relazioni registrate tra i componenti permettono di risalire dall’anomalia al servizio coinvolto, e da lì agli utenti che ne subiscono le conseguenze.
Un CMDB aggiornato diventa così un riferimento condiviso tra chi gestisce l’infrastruttura e chi gestisce il servizio. Entrambi i team leggono gli stessi dati, ciascuno con le proprie finalità.
Molti incidenti iniziano da un change
Una buona parte dei disservizi ha origine da una modifica recente.
Se le informazioni sui change restano separate da quelle operative, individuare questo legame richiede verifiche manuali. In un approccio ServiceOps il team può controllare subito se un’anomalia coincide con un intervento pianificato e decidere più rapidamente come procedere.
Lo stesso vale in senso inverso. I dati raccolti sugli incidenti passati aiutano a valutare con più precisione il rischio dei change futuri.
L’automazione riduce i passaggi manuali
La convergenza tra ITSM e IT Operations è favorita anche dall’evoluzione dell’automazione e dell’intelligenza artificiale.
Un incidente generato da un alert può essere assegnato automaticamente al gruppo competente, già arricchito con i dati tecnici raccolti dal monitoraggio.
Il tempo recuperato nello smistamento delle attività può essere dedicato all’analisi del problema, che resta il lavoro in cui l’esperienza delle persone fa la differenza.
Due team, un unico flusso di lavoro
ITSM e IT Operations continueranno ad avere responsabilità diverse. Quello che cambia è il modo in cui collaborano.
Quando segnali tecnici e incidenti convivono nello stesso ambiente, il percorso dal problema alla soluzione diventa più breve. I team tecnici vedono l’impatto del loro lavoro sugli utenti, mentre il service desk può aggiornare le persone coinvolte con informazioni precise.
Con Deepser, service desk e team operativi lavorano sulla stessa piattaforma. Gli alert dei sistemi di monitoraggio diventano automaticamente ticket, collegati al CMDB, che mostra subito quali servizi e quali utenti sono coinvolti e aiuta a valutare l’impatto di un change prima di pianificarlo.
Prova la demo gratuita e scopri come possiamo supportare la tua azienda.