In una piattaforma SaaS, la disponibilità del servizio racconta solo una parte di ciò che sta accadendo. Un sistema può risultare operativo e mostrare comunque segnali di degrado nell’esperienza degli utenti. Quando emerge un’anomalia, sapere che esiste è utile, ma per intervenire serve capire da dove nasce e quali componenti sono coinvolti.
Da questa esigenza nasce la distinzione tra Monitoring e Observability. Il monitoring controlla lo stato di applicazioni e infrastrutture attraverso indicatori definiti in precedenza. L’observability permette invece di ricostruire il comportamento interno del sistema attraverso i dati che produce durante il funzionamento. Per chi gestisce un SaaS, significa avere due livelli di lettura complementari, uno dedicato al controllo e l’altro all’analisi delle cause.
Nel mondo SaaS questa capacità di lettura ha un peso particolare perché ogni esperienza digitale dipende da una rete di servizi che devono comunicare tra loro. Anche una singola operazione visibile all’utente può attraversare diversi livelli dell’applicazione prima di essere completata. Se uno di questi passaggi rallenta o genera un errore, l’effetto può riflettersi immediatamente sulla qualità del servizio. Per il provider significa dover individuare rapidamente l’origine dell’anomalia, limitare l’impatto sugli utenti e fornire al team tecnico informazioni utili per intervenire. Maggiore è la visibilità su ciò che accade all’interno della piattaforma, minore è la distanza tra il primo segnale e l’individuazione della causa.
Potrebbe interessarti anche:
XLA vs SLA: le metriche orientate all’esperienza che trasformano il supporto IT
Il Monitoring parte da ciò che sappiamo di dover osservare
Ogni attività di monitoring nasce dalla definizione di parametri da tenere sotto controllo. Il team stabilisce quali valori osservare e quali soglie richiedono attenzione.
Se un indicatore supera il limite previsto, viene generato un alert. Il team riceve così un segnale immediato e può verificare lo stato del servizio interessato.
Il monitoring funziona particolarmente bene quando il comportamento da individuare è già conosciuto. Permette di seguire le performance con continuità e di reagire rapidamente alle variazioni più rilevanti.
Quando però l’origine dell’anomalia non è evidente, il solo valore registrato può lasciare aperte diverse domande.
L’Observability ricostruisce ciò che accade dietro il segnale
È in questa fase che l’observability assume un ruolo diverso.
Supponiamo che una funzione della piattaforma inizi a richiedere più tempo per completare una richiesta. Il dato sulla latenza mostra il cambiamento, mentre l’analisi dei segnali prodotti dal sistema permette di seguirne il percorso.
Il team può così individuare il punto in cui si concentra il ritardo e verificare cosa stava accadendo in quel momento.
Questo rende possibile investigare anche comportamenti che non erano stati previsti quando sono stati configurati dashboard e alert.
Metriche, log e trace mostrano prospettive diverse
Per ricostruire il comportamento di un’applicazione SaaS servono informazioni provenienti da livelli differenti.
Le metriche aiutano a individuare variazioni nelle performance e nello stato dei servizi.
I log documentano gli eventi generati durante l’esecuzione delle attività e permettono di approfondire ciò che è accaduto in un determinato passaggio.
I trace seguono invece una richiesta lungo il suo percorso tra i servizi coinvolti.
Il valore emerge quando queste informazioni vengono collegate. Una variazione rilevata nelle metriche può essere associata a un evento registrato nei log e poi localizzata attraverso il trace della richiesta interessata.
Le dipendenze rendono meno immediata la ricerca della causa
Una piattaforma SaaS raramente funziona come un unico blocco.
Le funzionalità disponibili agli utenti dipendono spesso da più servizi che comunicano tra loro. A questi si aggiungono risorse esterne e integrazioni che partecipano all’esecuzione di determinate operazioni.
Di conseguenza, il punto in cui l’utente percepisce il problema può essere distante dalla sua origine tecnica.
L’observability permette di seguire queste relazioni e offre al team una lettura più ampia del comportamento dell’applicazione. Questo riduce la quantità di verifiche necessarie per capire dove concentrare l’analisi.
Più alert non significano necessariamente più visibilità
Un singolo problema può generare diverse segnalazioni all’interno dell’infrastruttura.
Se ogni evento viene analizzato in modo isolato, il team rischia di dedicare risorse alla stessa causa più volte. Inoltre, un volume elevato di notifiche rende più difficile stabilire rapidamente quali richiedano attenzione immediata.
Correlare i segnali aiuta a riconoscere quando più alert appartengono allo stesso incidente.
La qualità dell’osservazione dipende quindi anche dalla capacità di creare relazioni tra le informazioni disponibili e di ridurre il rumore durante l’analisi.
Il vero valore emerge durante la gestione degli incidenti
La differenza tra ricevere un alert e comprenderne l’origine diventa particolarmente evidente durante un incidente.
Quando il team dispone già delle informazioni necessarie per localizzare il problema, può iniziare le attività di gestione con una base più completa. Si riduce così il lavoro dedicato alla ricerca preliminare e aumenta la velocità con cui il caso può essere indirizzato verso le persone giuste.
È qui che il legame con l’IT Service Management assume particolare rilevanza.
I dati provenienti dagli strumenti tecnici possono accompagnare l’incidente all’interno del workflow di gestione. Gli operatori hanno quindi accesso alle informazioni raccolte durante l’analisi senza dover ricostruire ogni passaggio manualmente.
Dal segnale all’azione
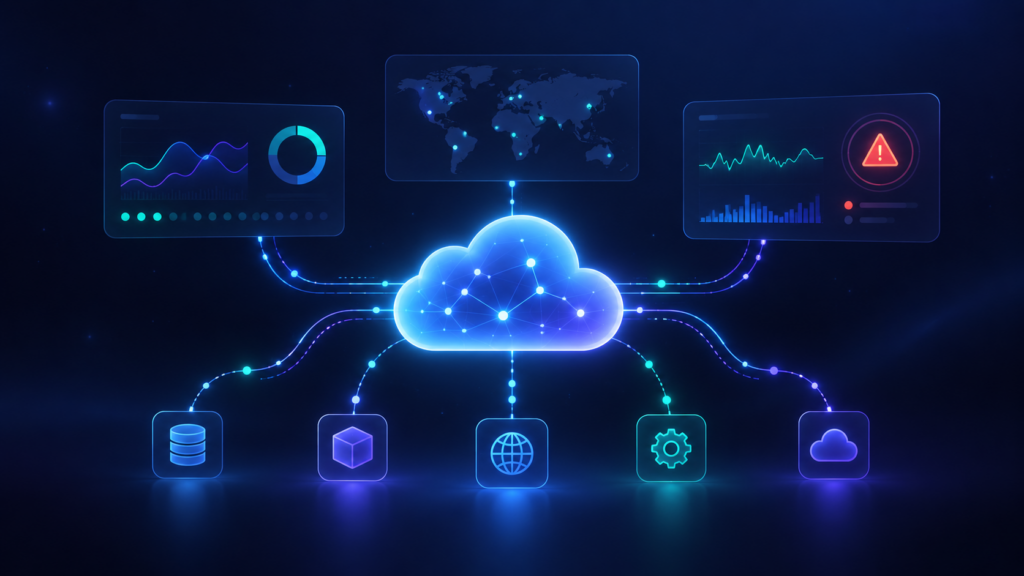
Monitoring e Observability coprono fasi diverse dello stesso percorso.
Il primo offre una visione continua dello stato dei servizi e segnala quando qualcosa si allontana dai valori attesi. La seconda permette di approfondire quel segnale e ricostruire ciò che accade all’interno dell’applicazione.
Per un SaaS, il vantaggio sta nella possibilità di accorciare la distanza tra la comparsa di un problema e l’individuazione della sua origine.
Quando queste informazioni entrano anche nei processi di Service Management, il passaggio successivo diventa più fluido. L’incidente può essere assegnato e seguito all’interno dello stesso flusso operativo.
Con Deepser, gli alert provenienti dai sistemi di monitoraggio possono essere integrati nei workflow di Service Management e gestiti direttamente come incidenti. Le automazioni supportano l’assegnazione delle attività, mentre gli SLA permettono di seguire la gestione fino alla risoluzione.
Prova la demo gratuita e scopri come possiamo supportare la tua azienda.